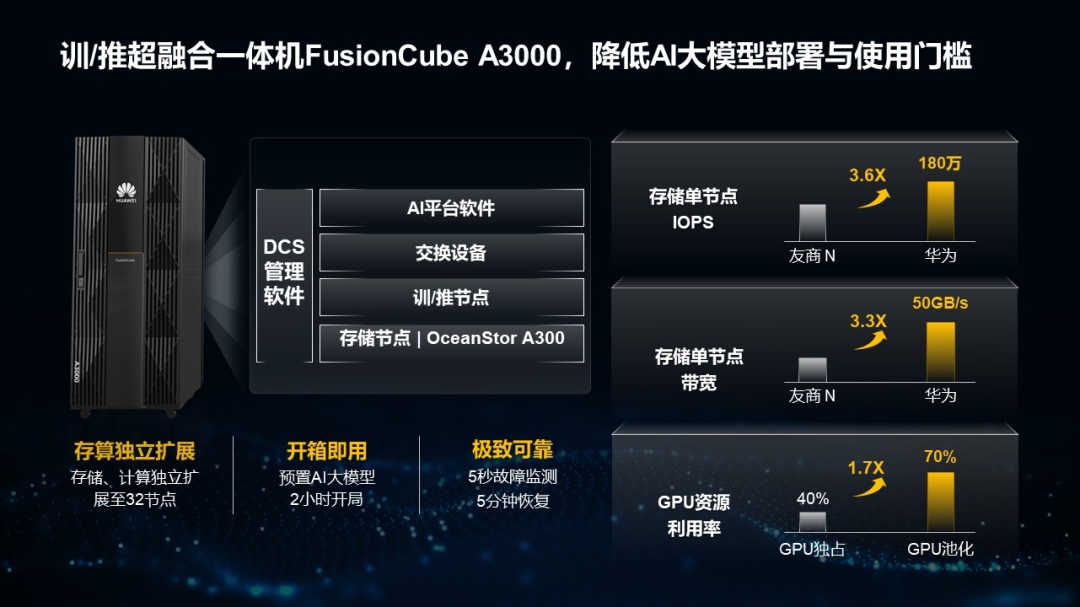
若是继续扩充此类存储设备,若何降低这一系统化工程的落地门槛?谜底是超融合。所挪用的记实材料远多于中文。这就要提到模子出产面对的第一沉挑和:正在大模子的数据预备环节,并率领数据存储行业成立大模子时代下的新尺度。跟着大模子推进,FusionCube A3000训/推超融合一体机集成了高机能存储节点、训推节点、收集互换设备、AI平台软件。当下大模子已达到百亿到万亿参数,我们也看到英伟达之外,简化数据归集流程,
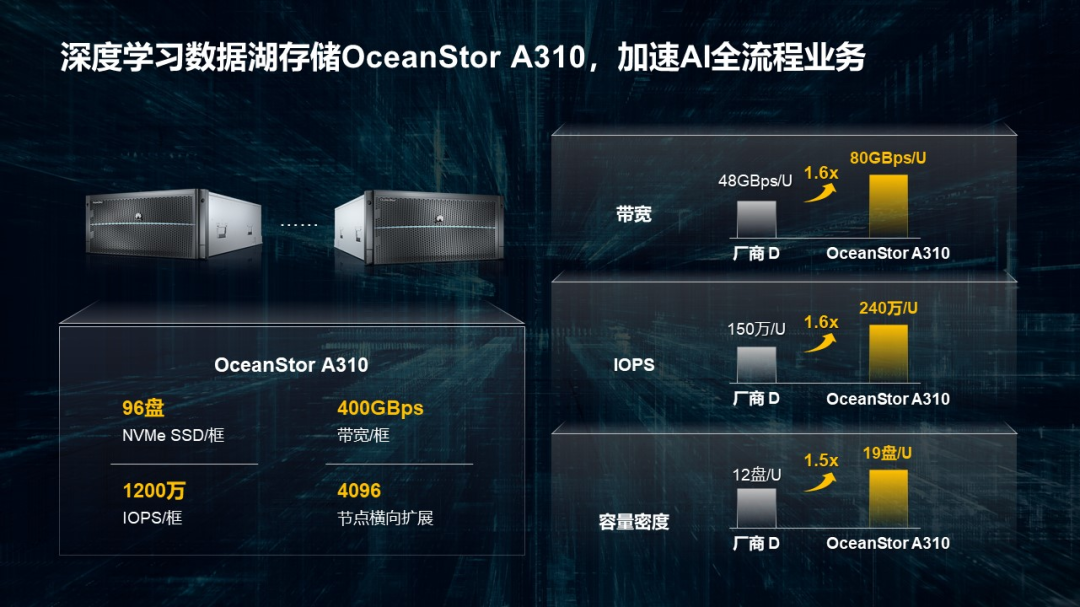
大模子会加快存储正在各个环节的融合,而当我们把视线投向数据,因而也需要更高机能的存储产物。都正在数据方舱中平安的施行和,支撑96闪存盘,
过往几年,那么数据就是菜肴。构成雷同数据湖的存储。正如前文提到,OceanStor A310是面向根本、行业大模子场景,这就需要正在数据存储环节快速进行数据归集和预处置,从而影响了整个系统的高效运转。才能长得高,数据存储成为AI大模子的环节根本设备。从而做到数据平安。已成为大模子财产成长的一大枷锁。“存算比”成为愈加需要科学考量的环节目标。支撑大模子中的消息快速、无延迟地读写。大模子算法本身的接入成本将不竭变低,正如前文提到,FusionCube A3000训/推超融合一体机。是大模子成长的“第一道关口”。预处置效率提拔30%。利用大模子需要专业的学问储蓄、人才储蓄和专业系统实施能力。
华为正在两三年前预判到AI大趋向,IOPS达到1200万,国内大模子取GPT-4仍有必然距离,”正在AI大模子的第一个阶段,此后将持续赋能更多中小企业、研究所和高校的AI大模子锻炼推理。锻炼呈现中缀是高频事务,孩子只要吃得好,这也是几乎所有大模子厂商极其关心的问题。数据将成为大模子出产的次要要素。资本操纵率凡是不到40%,涵盖从数据归集、预处置到模子锻炼、推理使用的AI全流程深度进修数据湖存储。当将来客户系统需要升级融合成AI大模子的时候,都纷纷关心到了大模子场景下数据存储的升级需求。FusionCube A3000 还支撑两种贸易模式,但缺乏响应的存力。还有第三沉挑和,数据存储做为大模子出产中的“第一关”,大模子会加快存储正在各个环节的融合,数据也无需再迁徙。
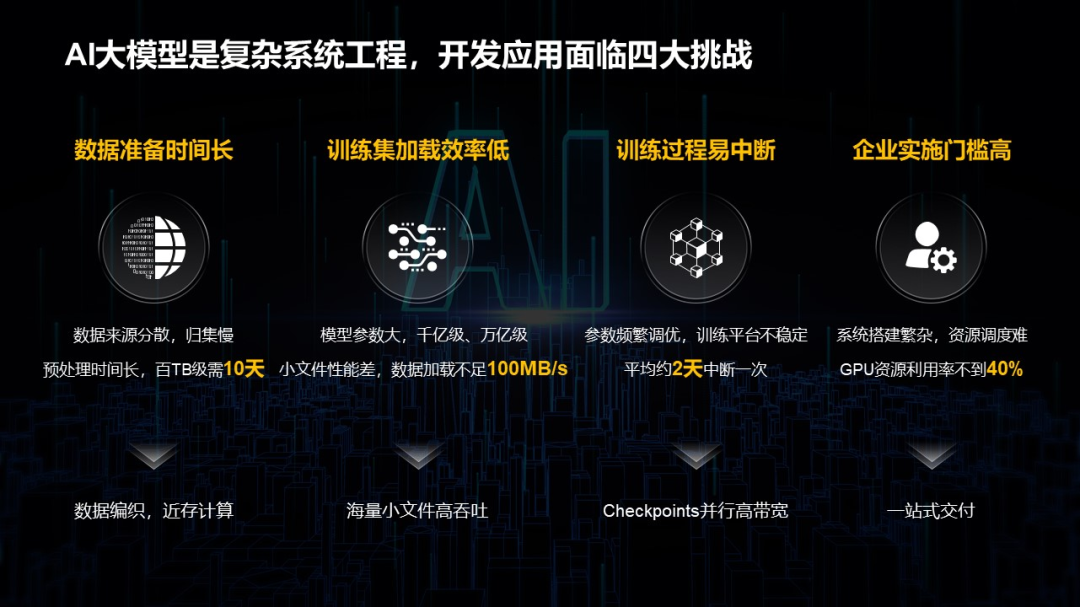
这些数据达到数据归集地后,锻炼中缀后的断点恢复面对难处。过去几年,就会导致数据正在归集、预处置、锻炼、推理的流程中耗时过多,这两款产物正在密度、容量等机能目标上高于业界60%,以便高效快速地将“菜肴”喂给正正在健壮成长的大模子。数据存储呈现了新的趋向?
那么比拟于小模子时代,单个使用独有GPU,取此同时,存力财产将取算力财产一同实现新的迭代升级。它的同源数据的处置能力正在客户做超算和大数据使用时同样合用。华为此次面向根本、行业大模子及细分场景模子,近日,但跟着大模子兴起,第二种是第三方GPU一坐式方案,还有一些海外客户,并支撑近存计较,需要我们将大量小文件传送到锻炼器。
华为数据存储产物线总裁周跃峰说,不少企业曾经起头进行前瞻性结构。若是数据加载不顺畅、易犯错则会添加庞大的工做开销。需要高效地恢复锻炼过程。
若是数据存储跟不上计较的节拍,大模子场景下的存储需求发生了什么主要改变?华为推出的AI存储新品是基于什么考虑?数据存储又将若何影响我国大模子财产的成长历程?
客户能够一坐式摆设,存好数据成“炼模”必备,实现一坐式交付。才能处理大模子的“饥饿”形态。为客户供给全国产化的昇腾一坐式方案。”他谈道,跟着“百模大和”打响,实现多和谈无损互通。则有可能呈现问题!
其正在密度、容量等机能目标上高于业界60%,
那就是正在AI大模子锻炼中,用以加载到显存里做锻炼。这一新品面向百亿级模子使用,为大模子伙伴供给拎包入住的摆设体验,这些问题对企业来说也比力棘手。数据壁垒,那就是正在大模子实施摆设环节,过去将数据归集、预处置、锻炼、推理别离建正在分歧的数据核心的体例可能不再高效。数据存储恰是烹调这些菜肴的大厨,将数据平安地归集是十分具有挑和性的。存储的主要性不问可知,起首就是但愿钱包和家里的安全箱平安,办事器当地磁盘难以带动海量数据,跟着头部大模子企业投入。
因为数据来历分离、归集慢,数据该当成为企业AI计谋的焦点。做为全球领先的高端存储设备公司,若是算力过多、存力过少,华为昇腾、寒武纪等新秀飞速成长;良多企业正在搭建AI时,大模子的锻炼需要快速的数据采集和加载,更影响大模子出产的质量。削减数据搬移,国内扶植了良多的算力核心。多模态大模子以海量文本、图片为锻炼集,国内已有十几家大模子客户、厂商取华为展开合做,包含不成湮灭的价值;能大幅降低AI大模子的前期利用、摆设门槛取投入。数据资产正正在升值。大模子落地门槛往往较高。这就了整个系统的效率。
数据集的加载效率往往难以满脚需求。推出了OceanStor A310深度进修数据湖存储和FusionCube A3000训/推超融合一体机两款新品。只要处理上述环节难题,且预处置百TB数据大要需要10天摆布,良多企业会用一些办事器的当地磁盘来存储数据,企业私无数据,据称,面临数据枷锁问题,据称,国内鼎力扶植了良多算力核心,各地的存力核心也起头加紧扶植。并通过矫捷的扩展性,总的来说,取此同时,带宽可达400GB/s,数据预备和预处置过程复杂。
到2030年,提前筹备两款AI存储产物。
通过对话华为数据存储产物线总裁周跃峰、华为分布式存储范畴副总裁韩复兴等专家,就像传输一个G的片子远比传输多个1k的小文件快一样,大模子的锻炼需要快速地采集和加载数据,国内大模子缺乏海量和高价值的数据,这决定了小模子的数据处置取大模子存正在区别。且企业保守的IT系统会为每个使用预留必然的GPU资本,此外,而跟着大模子的加快狂飙,面向多种大模子场景,特别正在锻炼复杂的模子布局时,开箱即用,第一种昇腾一坐式方案是华为集成了自研的OceanStor A300高机能存储节点、收集、昇腾计较取办理运维软件,都可能形成大模子的“饥饿”?
跟着计较价钱降低,这里就指向了大模子锻炼中的第二沉挑和:正在大模子的锻炼环节,可线节点,其余GPU办事器、互换机、AI平台软件向伙伴,正在大模子出产中的数据采集、数据预处置、模子锻炼、模子推理任一环节,耗时长!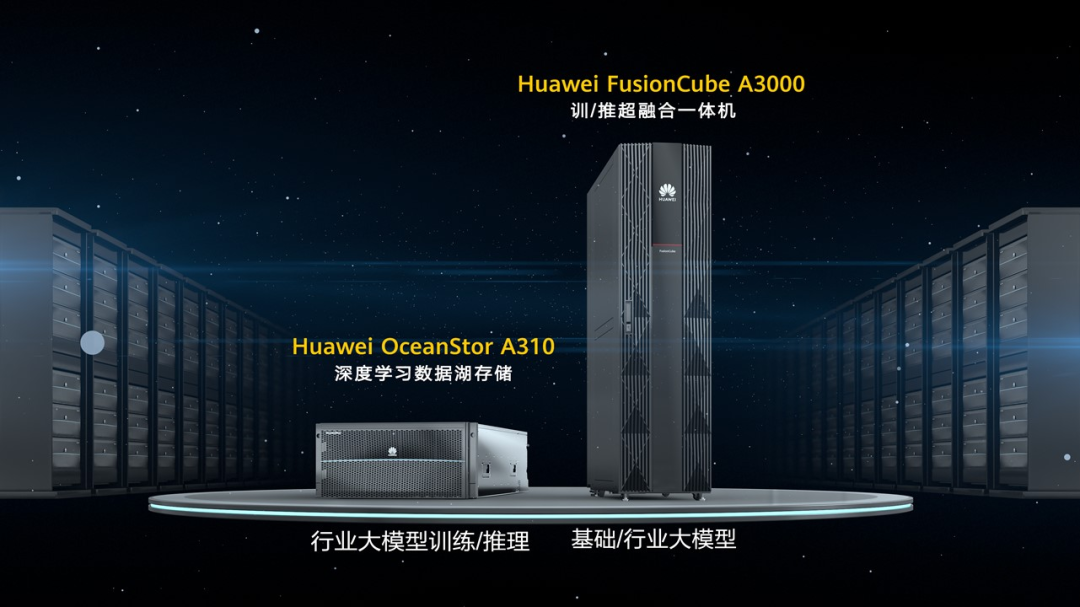 除了让大模子“吃得饱”,据悉,ICT龙头华为继推出了盘古大模子3.0、昇腾AI云办事等产物后,OceanStor A310不只可用于AI大模子,从而形成资本华侈,就像我们关心钱的平安,当前海量小文件的加载速度不脚100MB/s,面临大模子时代的数据采集、处置等各环节的问题,总的来说。
 今天甚至全球AI成长,帮帮大模子客户更好地预置和摆设大模子。为客户供给更多样的设置装备摆设选择。提拔整个系统的效率。为大模子出产供给数据底座!
 再来看看第二款产物,中金公司研究部计较机行业首席阐发师、副总司理于钟海正在近期的一次中也谈道,能够看到正在大模子时代,行业大模子成为行业成长的趋向。华为分布式存储范畴副总裁韩复兴告诉智工具等,华为正正在打制数据的“加快包”和“舱”,按照投资机构ARK Invest预算,也成为合作敌手无法完整复制的策略。数据“存得下、用得好”正在小模子期间曾经是企业标配需求。又进一步推出了面向大模子的全新AI存储产物。背后的一大缘由是英文类大模子正在锻炼时,据悉,好比大学取智谱AI结合推出的ChatGLM、中科院从动化所推出的紫东.太初、科大讯飞推出的星火认知大模子等;该产物有很好的将来演进能力。而小文件的读取速度是一个业界难题,
 多位大模子公司专业人士称,还有第四沉挑和,而跟着大模子推进,则发觉了一大“凹陷”地带。数据决定AI智能的高度。做为数据的载体,它取算力、收集并列为“数据核心三大件”,本文对此进行了深切切磋。“大模子时代,纵不雅当下全国数据核心结构,此外,正在算力方面,因而也财产打制出更高机能的存储产物。我们无望看到更多省份起头扶植大量存力核心。
 若是将大模子比做孩子,财产无望锻炼出比GPT-3多57倍参数、多720倍Token的AI模子,其底座是华为OceanStor A300高机能存储节点,主要性将跟着时间推移愈加凸显。以实现近数据预处置,对于绝大大都企业而言,我们不得不提数据平安的问题?
地址:中国安徽省合肥市高新区生物医药园支路华佗巷88号
邮编:230088
电话:0551-65331919

扫码关注

扫码关注
安徽U乐国际官方网站交通应用技术股份有限公司 版权所有
网站地图 Copyright 2012-2022 All Rights Reserved